来源页 · 完整讲稿 · 第 12 讲
自我复制的降维打击
你好,我是王立铭,欢迎来到生命科学50讲。
上节课你知道了自我复制,或者说繁衍,是比永生更重要的事情。因为有了自我复制,生命才能过五关斩六将,战胜意外,适应变化,存活到今天。那么,自我复制这么重要的事到底是怎么实现的呢?今天,我就带你来看看自我复制的机制。
蛋白质无法独立自我复制
今天这节课可能有点烧脑,希望你能紧跟我的思路。首先,我们来做一个思维体操,在纸面上构造一个极端简化的生命,探讨一下生命自我复制的原理。
这个最简单的生命,应该就是一个蛋白质分子,我们可以给它取名叫生命1.0。
从前面的故事里你可以很容易地想象,最有资格入选的蛋白质大概就是ATP合成酶,因为它是为生命制造能量货币的。有了它,生命就可以制造ATP分子,然后用ATP来驱动各种生命活动了。
但是问题来了:生命1.0——也就是ATP合成酶——几乎不可能实现自我复制。
为什么呢?因为这个古老的蛋白质虽然尺寸很小,只有几个纳米大,但是,它却蜷曲折叠成了一个空间结构非常复杂,带有三个叶片、一个管道的精细三维结构。在氢离子的推动下,这个微型发电机的叶片还可以旋转不停,产生ATP分子。
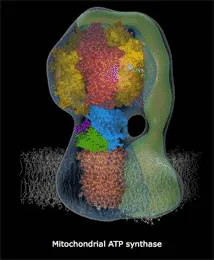
ATP合成酶工作原理示意图
这个机器里每一个原子排列的精确度需要达到零点几个纳米的水平。空间位置稍微错一点,化学性质改变一点,它就没法工作了。而且它工作的时间精度也非常高,每一秒钟可以旋转上百次。
所以你可以想象,要想完美复制这个三维分子机器,对时空精度的要求都是非常苛刻的。
其实,别说复制起来困难,就算要看得清楚一些都不容易。举个例子:
在上世纪90年代,英国科学家约翰·沃克(John Ernest Walker)利用x射线衍射的方法,看清了这个蛋白质的三维晶体结构,他在三年之后就靠这个发现获得了诺贝尔奖。你可以想象,这是一个多么微小而精密的生命构件。
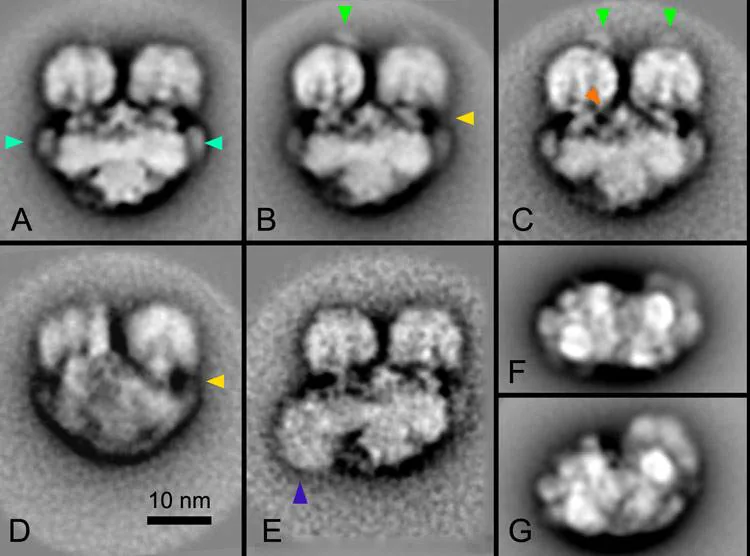
ATP合成酶晶体结构
所以,从逻辑上说,生命体需要一种办法,能更简单,但是也更精确地记录和复制自身。
最好不要让我们瞪大眼睛去记录和复制一个超级复杂的三维结构,而且还得记录它在每个时刻下,每一点的空间信息。这样太繁琐,也太容易出错了。
其实,我们可以回头来想想ATP合成酶的构造,看看会不会有启发。
这个分子机器是由许多个蛋白质零件拼装起来的,加起来一共需要五千多个氨基酸分子,按照某种特定的顺序组装。当然,这个组装步骤不需要人类或者外部力量的参与。在三维空间中,这些氨基酸彼此吸引、排斥、碰撞、结合,能够自己形成复杂、动态的三维结构。
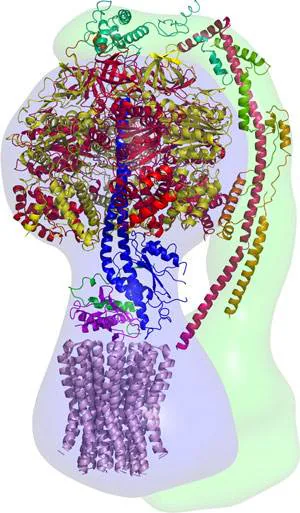
ATP合成酶的蛋白质分子尺度图
DNA的降维打击和两个优势
那么,到底怎样才能设计一个简单的方法,把这五千多个氨基酸的先后顺序和位置忠实地记录和复制下来呢?
不得不说,地球生命想到了一个非常巧妙的方法。我可以套用一个流行的科幻名词——降维打击——来解释这件事。
这个概念最早来自刘慈欣的科幻小说《三体-死神永生》。简单来说,就是生命简化了记录和复制的难度,把立体的、三维空间里的蛋白质信息,记录在了线性的、一维的DNA分子上面。
那这个过程具体是怎么实现的呢?
这就要说到DNA这种物质的奇妙特性了。DNA你必然听说过,它的中文全称叫脱氧核糖核酸。几乎每个地球生命都依赖DNA存储自身的遗传信息,用来指导生命活动,实现自我复制。
和蛋白质一样,DNA也是尺寸很大的生命物质。但它和蛋白质不一样的地方是,蛋白质在空间尺度上非常复杂,在时间尺度上又瞬息万变。
而DNA化学性质很简单,并且是一维的,也就是线性的,因此它进行信息存储和复制的过程就要比蛋白质简单得多。
为什么这么说呢?我们先来看看DNA长什么样。
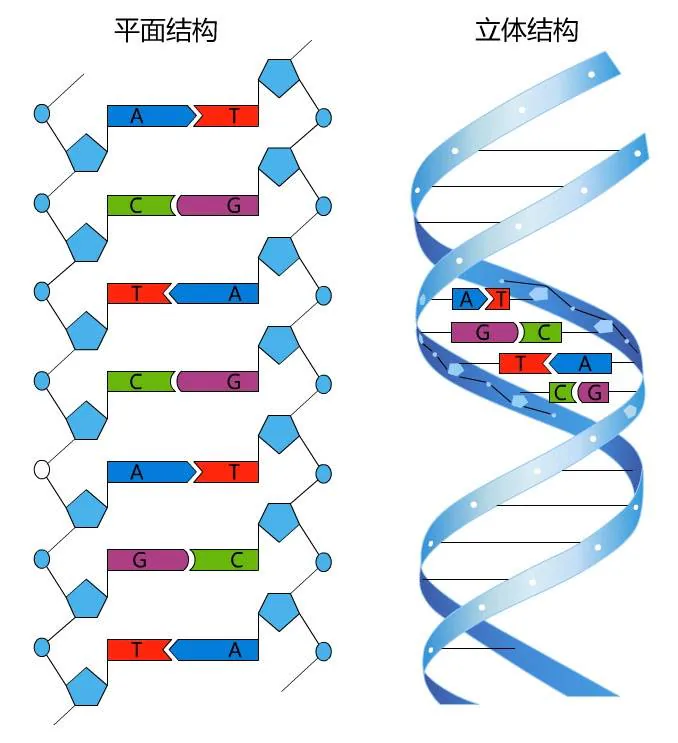
DNA上的碱基对组合
DNA的化学构造比蛋白质简单。我们说过,蛋白质分子可以看成是20种氨基酸分子按照特定的顺序首尾相连先形成链条,然后这根链条、或者几根链条在一起缠绕、折叠、扭曲,形成一个有立体形状的蛋白质分子机器,而这台分子机器如何工作,完全取决于这个三维形态的细节构造。
而DNA呢?它是由4种碱基分子构成的链条。顺便说一句,这4种碱基的名字你在中学生物课肯定也学过:腺嘌呤、鸟嘌呤、胸腺嘧啶和胞嘧啶。具体的名字你不用记,用A、G、T、C这4个英文字母来代表就行。
那为什么说DNA是一维线性的呢?在生物体内部,DNA分子当然也是有三维结构的,也是会经常发生空间结构的变化的。
但是和蛋白质不一样的是,不管空间结构怎么变化,DNA分子上面所携带的信息是恒定不变的——永远都是按照3个相邻的碱基,对应1个氨基酸的方式,来记录蛋白质分子里面氨基酸的先后顺序。
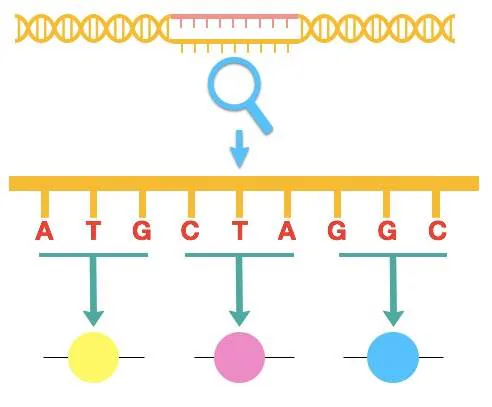
DNA链上的3个相邻碱基对应1个氨基酸
打个比方:
- 如果3个相邻的碱基是ATG,对应的就是一个蛋氨酸;
- 如果是AAG,那对应的就是赖氨酸;
- 如果是6个碱基,ATGAAG连起来,对应的就是一个蛋氨酸,后面连一个赖氨酸。
就这么简单。
不管这一段DNA分子是扭曲还是拉直,是在活动还是锁死,碱基分子之间的先后顺序是不会发生变化的,永远都是ATGAAG。所以,它所携带的信息也是不会变化的,对应的永远就是这两个氨基酸连在一起。
这就像是你抄写一篇文章,不管你是钢笔抄还是铅笔抄,是横着写还是竖着写,是顺着抄还是倒着抄,单从信息复制和传递的角度,你做的事情是完全一样的。
这样一来,任何一个三维空间里复杂的蛋白质分子,它的全部信息,也就是它所有氨基酸分子的排列顺序,都可以被记录在一条一维线性的DNA分子长链上。
那为什么复制一根一维线性的分子,比复制三维分子机器要容易得多呢?
如果你还有点迷糊,我就再打一个比方:
- 想要精细地复制一个蛋白质,就像是给你一个机器,让你反向工程。先把机器里面每一个细节都搞清楚,然后再从无到有地制造出一个完全一样的机器,困难程度可想而知。
但是复制DNA就像是给你一本机器的制造手册,只要你每个字符都抄对,手册里的信息就是完好无损的,这当然就简单多了。
这就是我所说的降维打击的概念。有了这个概念,我们就可以设计出生命的2.0版本。
在这个版本里,除了执行具体生命活动任务的蛋白质分子机器,还有一套忠实记录这些分子机器制造信息的DNA分子。
在生命2.0需要自我复制的时候,它就不需要去操心三维尺度的复制问题了,它只需要复制一维尺度的DNA分子就可以了,所有的遗传信息都在DNA分子上。
生命完成自我复制以后,在它的子孙后代的身体里,这条DNA分子就可以按照3个碱基对应1个氨基酸的规则,重新制造蛋白质分子机器,新的生命就可以照常运转了。
其实,DNA分子作为遗传信息的载体,不光能够实现降维打击,而且还有两个别的好处。
首先是精确性。DNA复制的时候,精度是非常高的,高到复制10亿次才会出错1次。这就保证了遗传信息能够很牢靠地代代相传。而偶然出现的错误呢,恰好又能给生物的变异和适应环境提供可能性。
其次它很节约,DNA存储信息的效率是非常高的。我提到过,DNA记录信息的方法是3个碱基对应1个氨基酸。你可能会觉得奇怪,为什么一定是3个碱基,不是2个碱基或者4个碱基呢?这里面的道理非常有意思。
刚才我说过,碱基分子一共是4种,而氨基酸分子一共是20种。我们可以计算一下怎么编码效率最高:
- 首先1个碱基对应1个氨基酸是不够用的,因为这样一来,4个碱基就只够代表4种氨基酸;
- 2个碱基对应1个氨基酸也不够,因为两个碱基的排列,一共只有4的2次方,也就是16种组合,还不够20;
- 而3个碱基对应一个氨基酸就绰绰有余了——3个碱基可以产生4的3次方,一共64种组合,要比氨基酸的数量大,还提供了一点冗余度;
- 而如果再往下计算,要是4个碱基对应1个氨基酸,那么就会产生4的4次方,一共256种组合,这就比氨基酸的数量大了一个数量级,显然是一种浪费。
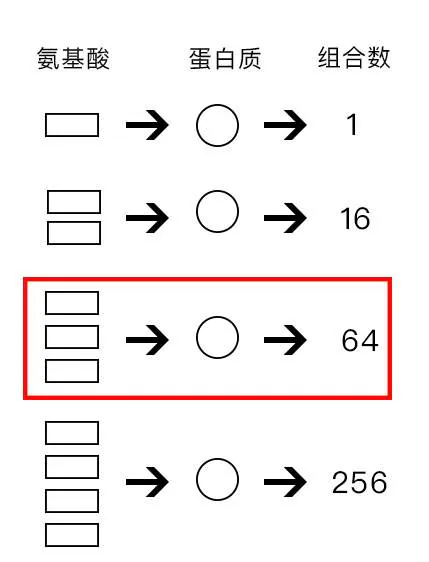
所以,地球生命在用DNA分子记录生物遗传信息的时候,使用的编码原则是恰好够用,但是又不浪费。
实际上今天也确实有人在试图研究如何用DNA分子来记录人类世界的海量信息,这个方法的存储效率比硬盘和U盘都要高不少。
总结一下,生命用了一个非常巧妙的方法解决了自我复制的难题,我形象地把它称作DNA的降维打击。在我看来,这是生命繁衍最精妙的秘密,也是关于生命最值得收藏的秘密。欢迎你把这一讲分享给和你一样热爱生命的朋友们。
那么接下来,DNA分子在技术层面是怎么完成复制的?特别是在地球生命出现的早期,生命形式肯定非常简单,但是遗传信息复制是个非常精密、复杂的任务,我们的祖先们是怎么做到的呢?
下节课,我会展开探讨这个看起来不可能完成的任务。
DNA的降维打击
一维的DNA分子,记录三维的蛋白质信息,大大简化了遗传信息记录和复制的难度。这就是关于生命最值得收藏的秘密。